Traductor

martes, 19 de julio de 2016

SISTEMAS DE MULTIPLES PROCESADORES

Desde su inicio, la industria de las computadoras se ha orientado fundamentalmente a buscar sin
pausa un poder de cómputo cada vez mayor. La ENIAC podía realizar 300 operaciones por segundo
—es decir, era 1000 veces más rápida que cualquier calculadora anterior a ella— pero aún así
las personas no estaban satisfechas. Las máquinas actuales son millones de veces más rápidas que
la ENIAC y sigue existiendo una demanda de mayor potencia de cómputo. Los astrónomos están
tratando de entender el universo, los biólogos tratan de comprender las implicaciones del genoma
humano y los ingenieros aeronáuticos están interesados en construir aeronaves más seguras y eficientes,
y todos ellos requieren más ciclos de la CPU. No importa cuánto poder de cómputo haya
disponible, nunca será suficiente.

De antemano en los sistemas Pentium de alto rendimiento, el enfriador de la CPU es más grande que la misma CPU. Con todo,
para pasar de 1 MHz a 1 GHz se requirió sólo una ingeniería cada vez mejor del proceso de fabricación
del chip; para pasar de 1 GHz a 1 THz se va a requerir una metodología radicalmente
distinta.
Una metodología para obtener una mayor velocidad es a través de las computadoras masivamente
en paralelo. Estas máquinas consisten en muchas CPUs, cada una de las cuales opera a una
velocidad “normal” (lo que eso signifique en cierto año específico), pero que en conjunto tienen
mucho más poder de cómputo que una sola CPU. Ahora hay sistemas con 1000 CPUs disponibles
comercialmente. Es probable que se construyan sistemas con 1 millón de CPUs en la siguiente década.
Aunque hay otras metodologías potenciales para obtener mayor velocidad, como las computadoras
biológicas, en este capítulo nos enfocaremos en los sistemas con varias CPUs convencionales. 


A continuación tenemos el sistema de la figura 8-1(b), en el cual varios pares de CPU-memoria
se conectan a una interconexión de alta velocidad. A este tipo de sistema se le conoce como multicomputadora
con paso de mensajes. Cada memoria es local para una sola CPU y puede ser utilizada
sólo por esa CPU. Las CPUs se comunican enviando mensajes de varias palabras a través de la interconexión.
Con una buena interconexión, un mensaje corto se puede enviar en un tiempo de 10 a
50 μseg, pero aún es más largo que el tiempo de acceso a la memoria de la figura 8-1(a). No hay memoria
global compartida en este diseño. Las multicomputadoras (es decir, sistemas de paso de mensajes)
son mucho más fáciles de construir que los multiprocesadores (memoria compartida), pero son
más difíciles de programar. Por lo tanto, cada género tiene sus admiradores.
El tercer modelo, que se ilustra en la figura 8-1(c), conecta sistemas de cómputo completos a través
de una red de área amplia como Internet, para formar un sistema distribuido. Cada uno de estos
sistemas tiene su propia memoria, y los sistemas se comunican mediante el paso de mensajes. La
única diferencia real entre la figura 8-1(b) y la figura 8-1(c) es que en esta última se utilizan computadoras
completas, y los tiempos de los mensajes son comúnmente entre 10 y 100 mseg. Este largo
retraso obliga a que estos sistemas débilmente acoplados se utilicen de maneras distintas a los sistemas
fuertemente acoplados de la figura 8-1(b). Los tres tipos de sistemas difieren en sus retrasos
por una cantidad aproximada a los tres órdenes de magnitud. Ésa es la diferencia entre un día y tres
años.

MULTIPROCESADORES
Un multiprocesador con memoria compartida (o sólo multiprocesador, de aquí en adelante) es
un sistema de cómputo en el que dos o más CPUs comparten todo el acceso a una RAM común. Un
programa que se ejecuta en cualquiera de las CPUs ve un espacio normal de direcciones virtuales
(por lo general paginadas).


En su mayor parte, los sistemas operativos multiprocesadores son sólo sistemas operativos regulares.
Manejan las llamadas al sistema, administran la memoria, proveen un sistema de archivos
y administran los dispositivos de E/S. Sin embargo, hay ciertas áreas en las que tienen características
únicas. Estas áreas son la sincronización de procesos, la administración de recursos y la programación
de tareas. A continuación analizaremos con brevedad el hardware de los multiprocesadores
y después pasaremos a ver las cuestiones relacionadas con estos sistemas operativos.


Hardware de multiprocesador
Aunque todos los multiprocesadores tienen la propiedad de que cada CPU puede direccionar toda la
memoria, algunos tienen la característica adicional de que cada palabra de memoria se puede leer con
la misma velocidad que cualquier otra palabra de memoria. Estas máquinas se conocen como multiprocesadores
UMA (Uniform Memory Access, Acceso uniforme a la memoria). Por el contrario, los multiprocesadores
NUMA (Non-uniform Memory Access, Acceso no uniforme a la memoria) no tienen
esta propiedad.


Multiprocesadores UMA con arquitecturas basadas en bus

Los multiprocesadores más simples se basan en un solo bus, como se ilustra en la figura 8-2(a). Dos
o más CPUs y uno o más módulos de memoria utilizan el mismo bus para comunicarse. Cuando
una CPU desea leer una palabra de memoria, primero comprueba si el bus está ocupado. Si está
inactivo, la CPU coloca la dirección de la palabra que desea en el bus, declara unas cuantas señales
de control y espera hasta que la memoria coloque la palabra deseada en el bus.
Si el bus está ocupado cuando una CPU desea leer o escribir en la memoria, la CPU espera sólo
hasta que el bus esté inactivo. Aquí es donde se encuentra el problema con este diseño. Con dos
o tres CPUs, la contención por el bus será manejable; con 32 o 64 será imposible. El sistema estará
totalmente limitado por el ancho de banda del bus, y la mayoría de las CPUs estarán inactivas la
mayor parte del tiempo.
La solución a este problema es agregar una caché a cada CPU, como se ilustra en la figura
8.2(b). La caché puede estar dentro del chip de la CPU, a un lado de ésta, en el tablero del procesador
o puede ser alguna combinación de las tres opciones anteriores. Como esto permite satisfacer
muchas operaciones de lectura desde la caché local, habrá mucho menos tráfico en el bus y el sistema
podrá soportar más CPUs. En general, el uso de caché no se realiza por cada palabra individual, sino
por bloques de 32 o 64 bytes. Cuando se hace referencia a una palabra, se obtiene su bloque completo
(conocido como línea de caché) y se coloca en la caché de la CPU que está en contacto con ella.


Otra posibilidad es el diseño de la figura 8-2(c), donde cada CPU tiene no sólo una caché, sino
también una memoria privada local que utiliza mediante un bus dedicado (privado). Para utilizar esta
configuración de manera óptima, el compilador debe colocar todo el texto del programa, las cadenas,
constantes y demás datos de sólo lectura, las pilas y las variables locales en las memorias
privadas.

Multiprocesadores UMA que utilizan interruptores de barras cruzadas

Aun con la mejor caché, el uso de un solo bus limita el tamaño de un multiprocesador UMA a 16 o
32 CPUs, aproximadamente. Para lograr algo más se necesita un tipo distinto de interconexión. El
circuito más simple para conectar n CPUs a k memorias es el interruptor (conmutador) de barras
cruzadas, que se muestra en la figura 8-3. Los interruptores de barras cruzadas se han utilizado
por décadas en los puntos de intercambio de los conmutadores telefónicos para conectar un
grupo de líneas entrantes a un conjunto de líneas salientes de manera arbitraria.


Multiprocesadores NUMA

Al igual que sus parientes UMA, proveen un solo espacio de direcciones a través de todas
las CPUs, pero a diferencia de las máquinas UMA, el acceso a los módulos de memoria locales
es más rápido que el acceso a los remotos. Por ende, todos los programas UMA se ejecutarán sin
cambios en las máquinas NUMA, pero el rendimiento será peor que en una máquina UMA a la misma
velocidad de reloj.
Las máquinas NUMA poseen tres características clave que, en conjunto, las distinguen de otros
multiprocesadores:
1. Hay un solo espacio de direcciones visible para todas las CPUs.
2. El acceso a la memoria remota es mediante instrucciones LOAD y STORE.
3. El acceso a la memoria remota es más lento que el acceso a la memoria local.


Tipos de sistemas operativos multiprocesador

Cada CPU tiene su propio sistema operativo.

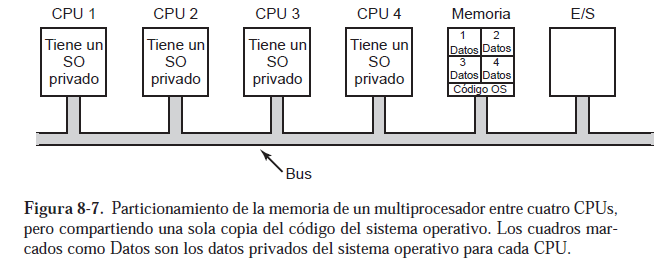
La manera más simple posible de organizar un sistema operativo multiprocesador es dividir estáticamente
la memoria y su propia copia privada del sistema operativo. En efecto, las n CPUs operan
entonces como n computadoras independientes. Una optimización obvia es permitir que todas las
CPUs compartan el código del sistema operativo y obtengan copias privadas sólo de las estructuras
de datos del sistema operativo, como se muestra en la figura 8-7.

Multiprocesadores maestro-esclavo

En la figura 8-8 se muestra un segundo modelo. Aquí, hay una copia del sistema operativo y sus tablas
presente en la CPU 1, y nada más ahí. Todas las llamadas al sistema se redirigen a la CPU 1
para procesarlas ahí. La CPU 1 también puede ejecutar proceso de usuario si tiene tiempo de sobra.
A este modelo se le conoce como maestro-esclavo, ya que la CPU 1 es el maestro y todas los demás
son los esclavos.

Multiprocesadores simétricos

Nuestro tercer modelo, el SMP (Multiprocesador simétrico), elimina esta asimetría. Hay una copia
del sistema operativo en memoria, pero cualquier CPU puede ejecutarlo. Cuando se hace una
llamada al sistema, la CPU en la que se hizo la llamada al sistema atrapa para el kernel y procesa
la llamada al sistema. El modelo SMP se ilustra en la figura 8-9.


Este modelo equilibra los procesos y la memoria en forma dinámica, ya que sólo hay un conjunto
de tablas del sistema operativo. También elimina el cuello de botella de la CPU, ya que no hay
maestro, pero introduce sus propios problemas. En especial, si dos o más CPUs están ejecutando
código del sistema operativo al mismo tiempo, se puede producir un desastre. Imagine que dos
CPUs seleccionan el mismo proceso para ejecutarlo, o que reclaman la misma página de memoria
libre. La solución más simple para estos problemas es asociar un mutex (es decir, bloqueo) con el
sistema operativo, convirtiendo a todo el sistema en una gran región crítica. Cuando una CPU desea
ejecutar código del sistema operativo, debe adquirir primero el mutex. Si el mutex está bloqueado,
sólo espera. De esta forma, cualquier CPU puede ejecutar el sistema operativo, pero sólo una a
la vez.

Sincronización de multiprocesadores

Para empezar, realmente se necesitan primitivas de sincronización apropiadas. Si un proceso en
una máquina uniprocesador (sólo una CPU) realiza una llamada al sistema que requiera acceder a
cierta tabla crítica del kernel, el código del kernel sólo tiene que deshabilitar las interrupciones antes
de tocar la tabla. Después puede hacer su trabajo, sabiendo que podrá terminar sin que ningún
otro proceso se entrometa y toque la tabla antes de que haya terminado. En un sistema multiprocesador,
deshabilitar las interrupciones sólo afecta a esa CPU, desshilitándola. Las demás CPUs se siguen
ejecutando y aún pueden tocar la tabla crítica. Como consecuencia, se debe utilizar un protocolo
de mutex apropiado, el cual debe ser respetado por todas las CPUs para garantizar que funcione la
exclusión mutua.
Ahora piense en lo que podría ocurrir en un multiprocesador. En la figura 8-10 podemos ver la
sincronización en el peor caso, en donde la palabra de memoria 1000, que se utiliza como bloqueo,
en un principio es 0. En el paso 1, la CPU 1 lee la palabra y obtiene un 0. En el paso 2, antes de que
la CPU 1 tenga la oportunidad de volver a escribir la palabra para que sea 1, la CPU 2 entra y también
lee la palabra como un 0. En el paso 3, la CPU 1 escribe un 1 en la palabra. En el paso 4, la
CPU 2 también escribe un 1 en la palabra. Ambas CPUs obtuvieron un 0 de la instrucción TSL, por
lo que ambas tienen ahora acceso a la región crítica y falla la exclusión mutua.


Para evitar este problema, la instrucción TSL debe primero bloquear el bus, para evitar que otras
CPUs lo utilicen; después debe realizar ambos accesos a la memoria, y luego desbloquear el bus.
Por lo general, para bloquear el bus se hace una petición del bus usando el protocolo de petición de
bus común, y después se declara (es decir, se establece a un 1 lógico) cierta línea de bus especial
hasta que se hayan completado ambos ciclos. Mientras que esté declarada esta línea especial, ninguna
otra CPU obtendrá acceso al bus. Esta instrucción puede implementarse sólo en un bus que
tenga las líneas necesarias y el protocolo (de hardware) para utilizarlas. Los buses modernos tienen
estas facilidades, pero en los primeros que no las tenían, no era posible implementar la instrucción
TSL en forma correcta. Ésta es la razón por la que se inventó el protocolo de Peterson: para sincronizar
por completo en el software (Peterson, 1981).

Planificación de multiprocesadores

Antes de analizar la forma en que se realiza la planificación en los multiprocesadores, es necesario
determinar qué es lo que se va a planificar. En los días de antaño, cuando todos los procesos tenían
un solo hilo, los procesos eran los que se planificaban; no había nada más que se pudiera planificar.
Todos los sistemas operativos modernos soportan procesos multihilo, lo cual complica aún más la
planificación.
Es importante saber si los hilos son de kernel o de usuario. Si la ejecución de hilos se lleva a
cabo mediante una biblioteca en espacio de usuario y el kernel no sabe nada acerca de los hilos, entonces
la planificación se lleva a cabo con base en cada proceso, como siempre. Si el kernel ni siquiera
sabe que los hilos existen, es muy difícil que pueda planificarlos.


Con los hilos del kernel sucede algo distinto. Aquí el kernel está al tanto de todos los hilos
y puede elegir y seleccionar de entre los hilos que pertenecen a un proceso. En estos sistemas, la
tendencia es que el kernel seleccione un hilo para ejecutarlo, y el proceso al que pertenece sólo
tiene un pequeño papel (o tal vez ninguno) en el algoritmo de selección de hilos. A continuación
hablaremos sobre la planificación de hilos, pero desde luego que, en un sistema con procesos con
un solo hilo, o con hilos implementados en espacio de usuario, son los procesos los que se programan.
Proceso contra hilo no es la única cuestión de planificación. En un uniprocesador, la planificación
es de una dimensión. La única pregunta que hay que responder (repetidas veces) es:
“¿Cuál hilo se debe ejecutar a continuación?”. En un multiprocesador, la planificación tiene dos
dimensiones: el planificador tiene que decidir qué hilo ejecutar y en cuál CPU lo va a ejecutar.
Esta dimensión adicional complica de manera considerable la planificación en los multiprocesadores.
Otro factor que complica las cosas es que, en ciertos sistemas, ninguno de los hilos está relacionado,
mientras que en otros se dividen en grupos donde todos pertenecen a la misma aplicación
y trabajan en conjunto. Un ejemplo del primer caso es un sistema de tiempo compartido, en
el que usuarios independientes inician procesos independientes. Los hilos de los distintos procesos
no están relacionados, y cada uno de ellos se puede planificar de manera independiente a los
demás.

Tiempo compartido
Vamos a analizar el caso de la programación de hilos independientes; más adelante consideraremos
cómo planificar hilos relacionados. El algoritmo de planificación más simple para lidiar con hilos
no relacionados es tener una sola estructura de datos a nivel de sistema para los hilos que estén listos,
que tal vez sea sólo una lista, pero es mucho más probable que sea un conjunto de listas para
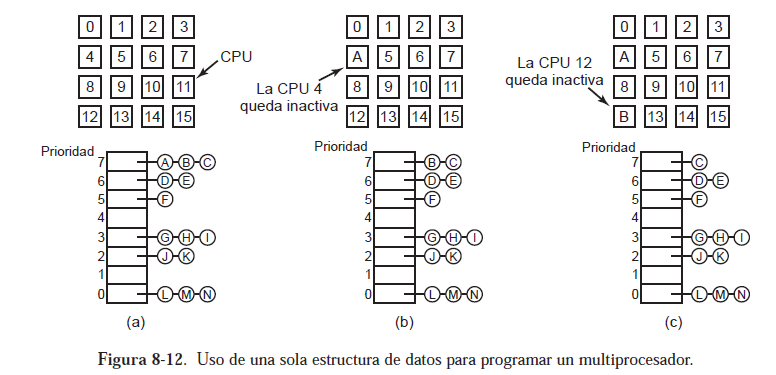
los hilos con distintas prioridades, como se ilustra en la figura 8-12(a). Aquí, las 16 CPUs están ocupadas
en un momento dado, y hay un conjunto de 14 hilos por orden de prioridad, esperando ser
ejecutados. La primera CPU en terminar su trabajo actual (o en hacer que su hilo se bloquee) es la
CPU 4, que después bloquea las colas de programación y selecciona el hilo con mayor prioridad
(A), como se muestra en la figura 8-12(b). A continuación, la CPU 12 queda inactiva y selecciona
el hilo B, como se ilustra en la figura 8-12(c). Mientras que los hilos no estén relacionados de ninguna manera, es una opción razonable llevar a cabo la planificación de esta forma, y es muy simple de implementar con eficiencia


Espacio compartido
El otro método general para la planificación de multiprocesadores se puede utilizar cuando los hilos
están relacionados entre sí de alguna manera. Anteriormente mencionamos el ejemplo del programa
make paralelo como uno de los casos. También ocurre con frecuencia que un solo proceso tenga varios
hilos que trabajen en conjunto. Por ejemplo, si los hilos de un proceso se comunican con mucha
frecuencia, es conveniente hacer que se ejecuten al mismo tiempo. A la planificación de varios hilos
al mismo tiempo, esparcidos sobre varias CPUs, se le conoce como espacio compartido.

En cualquier instante, el conjunto de CPUs se divide de manera estática en cierto número de
particiones, cada una de las cuales ejecuta los hilos de un hilo. Por ejemplo, en la figura 8-13 hay
particiones con 4, 6, 8 y 12 CPUs, y hay 2 CPUs sin asignar. Con el tiempo cambiará el número y
el tamaño de las particiones, a medida que se creen nuevos hilos y cuando los anteriores terminen
de ejecutarse.


Planificación por pandilla

Es una consecuencia de la
co-planificación (Ousterhout, 1982). La planificación por pandilla consta de tres partes:
1. Los grupos de hilos relacionados se programan como una unidad, o pandilla.
2. Todos los miembros de una plantilla se ejecutan en forma simultánea, en distintas CPUs de
tiempo compartido.
3. Todos los miembros de la pandilla inician y terminan sus intervalos en conjunto.

En la figura 8-15 se muestra un ejemplo del funcionamiento de la planificación por pandilla.
Aquí tenemos un multiprocesador con seis CPUs que son utilizadas por cinco procesos (A a E), con
un total de 24 hilos listos para ejecutarse. Durante la ranura de tiempo 0, se programan los hilos A0
a A6 y se ejecutan. Durante la ranura de tiempo 1, se programan los hilos B0, B1, B2, C0, C1 y C2, y
se ejecutan. Durante la ranura de tiempo 2, se ejecutan los cinco hilos de D y E0. Los seis hilos restantes
que pertenecen al hilo E se ejecutan en la ranura de tiempo 3. Después se repite el ciclo, donde
la ranura 4 es igual a la ranura 0, y así en lo sucesivo.


sábado, 9 de julio de 2016

INTERBLOQUEOS

Los sistemas computacionales están llenos de recursos que pueden ser utilizados por sólo un proceso
a la vez. Algunos ejemplos comunes son las impresoras, las unidades de cinta y las ranuras en
los tableros internos del sistema. Cuando dos procesos escriben de manera simultánea en la impresora
se producen incoherencias. Si dos procesos utilizan la misma entrada en la tabla del sistema de
archivos invariablemente se corrompe el sistema de archivos. En consecuencia, todos los sistemas
operativos tienen la habilidad de otorgar (en forma temporal) a un proceso el acceso exclusivo a
ciertos recursos.
Para muchas aplicaciones, un proceso necesita acceso exclusivo no sólo a un recurso, sino a
varios. Por ejemplo, suponga que cada uno de dos procesos quiere grabar un documento digitalizado
en un CD. El proceso A pide permiso para utilizar el escáner y se le otorga. El proceso B se programa
de manera distinta y solicita primero el grabador de CDs, y también se le otorga. Ahora A
pide el grabador de CDs, pero la petición se rechaza hasta que B lo libere. Por desgracia, en vez de
liberar el grabador de CD, B pide el escáner. En este punto ambos procesos están bloqueados y permanecerán
así para siempre. A esta situación se le conoce como interbloqueo.


RECURSOS
Una clase principal de interbloqueos involucra a los recursos, por lo que para empezar nuestro estudio
veremos lo que son. Los interbloqueos pueden ocurrir cuando a los procesos se les otorga acceso
exclusivo a los dispositivos, registros de datos, archivos, etcétera. Para que el análisis sobre
los interbloqueos sea lo más general posible, nos referiremos a los objetos otorgados como recursos.
Un recurso puede ser un dispositivo de hardware (por ejemplo, una unidad de cinta) o una pieza
de información (como un registro bloqueado en una base de datos).

Recursos apropiativos y no apropiativos
Los recursos son de dos tipos: apropiativos y no apropiativos. Un recurso apropiativo es uno que
se puede quitar al proceso que lo posee sin efectos dañinos. La memoria es un ejemplo de un recurso
apropiativo. Por ejemplo, considere un sistema con 256 MB de memoria de usuario, una impresora
y dos procesos de 256 MB, cada uno de los cuales quiere imprimir algo. El proceso A
solicita y obtiene la impresora, y después empieza a calcular los valores a imprimir. Antes de terminar
con el cálculo, excede su quantum de tiempo y se intercambia por el otro proceso.
Ahora el proceso B se ejecuta y trata (sin éxito) de adquirir la impresora: se crea una situación
potencial de interbloqueo, ya que A tiene la impresora y B tiene la memoria, y ninguno puede proceder
sin el recurso que el otro posee. Por fortuna, es posible apropiarse (quitar) de la memoria de
B al intercambiarlo y colocar el proceso A de vuelta. Ahora A se puede ejecutar, realizar su impresión
y después liberar la impresora. Así no ocurre ningún interbloqueo.
Por el contrario, un recurso no apropiativo es uno que no se puede quitar a su propietario actual
sin hacer que el cómputo falle. Si un proceso ha empezado a quemar un CD-ROM y tratamos
de quitarle de manera repentina el grabador de CD y otorgarlo a otro proceso, se obtendrá un CD
con basura. Los grabadores de CD no son apropiativos en un momento arbitrario.

La secuencia de eventos requerida para utilizar un recurso se proporciona a continuación, en
un formato abstracto.
1. Solicitar el recurso.
2. Utilizar el recurso.
3. Liberar el recurso.

Adquisición de recursos
Para ciertos tipos de recursos, como los registros de una base de datos, es responsabilidad de los
procesos de usuario administrar su uso. Una manera de permitir que los usuarios administren los recursos
es asociar un semáforo con cada recurso. Estos semáforos se inicializan con 1. Se pueden
utilizar mutexes de igual forma. Los tres pasos antes listados se implementan como una operación
down en el semáforo para adquirir el recurso, usarlo y finalmente realizar una operación up en el
recurso para liberarlo. Estos pasos se muestran en la figura 6-1(a).


Ahora consideremos una situación con dos procesos, A y B, y dos recursos. En la figura 6-2 se
ilustran dos escenarios. En la figura 6-2(a), ambos procesos piden los recursos en el mismo orden.
En la figura 6-2(b), los piden en un orden distinto. Esta diferencia puede parecer insignificante, pero
no lo es.
En la figura 6-2(a), uno de los procesos adquirirá el primer recurso antes del otro. Después ese
proceso adquirirá con éxito el segundo recurso y realizará su trabajo. Si el otro proceso intenta adquirir
el recurso 1 antes de que sea liberado, el otro proceso simplemente se bloqueará hasta que esté
disponible.
En la figura 6-2(b), la situación es distinta. Podría ocurrir que uno de los procesos adquiera ambos
recursos y en efecto bloquee al otro proceso hasta que termine. Sin embargo, también podría
ocurrir que el proceso A adquiera el recurso 1 y el proceso B adquiera el recurso 2. Ahora cada uno
se bloqueará al tratar de adquirir el otro. Ninguno de los procesos se volverá a ejecutar. Esa situación
es un interbloqueo.


miércoles, 6 de julio de 2016

DISCOS


Hardware de disco
Los discos son de varios tipos. Los más comunes son los discos magnéticos (discos duros y flexibles).
Se caracterizan por el hecho de que las operaciones de lectura y escritura son igual de rápidas, lo que
los hace ideales como memoria secundaria (como paginación o sistemas de archivos, por ejemplo).
Algunas veces se utilizan arreglos de estos discos para ofrecer un almacenamiento altamente confiable.
Para la distribución de programas, datos y películas, son también importantes varios tipos de discos
ópticos (CD-ROMs, CD-grabable y DVD). En las siguientes secciones describiremos primero el
hardware y luego el software para estos dispositivos.

Discos magnéticos
Los discos magnéticos se organizan en cilindros, cada uno de los cuales contiene tantas pistas como
cabezas apiladas en forma vertical. Las pistas se dividen en sectores. El número de sectores alrededor
de la circunferencia es por lo general de 8 a 32 en los discos flexibles, y hasta varios cientos
en los discos duros. El número de cabezas varía entre 1 y 16.
Los discos antiguos tienen pocos componentes electrónicos y sólo producen un flujo de bits serial
simple. En estos discos el controlador realiza la mayor parte del trabajo. En otros discos, en especial
los discos IDE (Electrónica de Unidad Integrada) y SATA (ATA Serial), la unidad de
disco contiene un microcontrolador que realiza un trabajo considerable y permite al controlador real
emitir un conjunto de comandos de nivel superior. A menudo el controlador coloca las pistas en caché,
reasigna los bloques defectuosos y mucho más.
Una característica de dispositivo que tiene implicaciones importantes para el software controlador
del disco es la posibilidad de que un controlador realice búsquedas en dos o más unidades al
mismo tiempo. Éstas se conocen como búsquedas traslapadas. Mientras el controlador y el software
esperan a que se complete una búsqueda en una unidad, el controlador puede iniciar una búsqueda
en otra unidad.
En la figura 5-18 se comparan los parámetros del medio de almacenamiento estándar para la
IBM PC original con los parámetros de un disco fabricado 20 años después, para mostrar cuánto
han cambiado los discos en 20 años. Es interesante observar que no todos los parámetros han mejorado
tanto. El tiempo de búsqueda promedio es siete veces mejor de lo que era antes, la velocidad
de transferencia es 1300 veces mejor, mientras que la capacidad aumentó por un factor de 50,000. Este patrón está relacionado con las mejoras relativamente graduales en las piezas móviles,
y densidades de bits mucho mayores en las superficies de grabación.


Algo que debemos tener en cuenta al analizar las especificaciones de los discos duros modernos
es que la geometría especificada y utilizada por el controlador es casi siempre distinta a la del
formato físico. En los discos antiguos, el número de sectores por pista era el mismo para todos los
cilindros. Los discos modernos se dividen en zonas, con más sectores en las zonas exteriores que
en las interiores. La figura 5-19(a) ilustra un pequeño disco con dos zonas. La zona exterior tiene
32 sectores por pista; la interior tiene 16 sectores por pista. Un disco real, como el WD 18300, tiene
por lo general 16 o más zonas, y el número de sectores se incrementa aproximadamente 4% por
zona, a medida que se avanza desde la zona más interior hasta la más exterior.


RAID

Como hemos visto, el procesamiento en paralelo se utiliza cada vez más para agilizar el rendimiento
de la CPU. Con el paso de los años, a varias personas se les ha ocurrido que la E/S en paralelo
podría ser una buena idea también. En su artículo de 1988, Patterson y colaboradores sugirieron
seis organizaciones de discos específicas que se podrían utilizar para mejorar el rendimiento del disco,
su confiabilidad o ambas características (Patterson y colaboradores, 1988). Estas ideas fueron
adoptadas de inmediato por la industria y han conllevado a una nueva clase de dispositivo de E/S conocido
como RAID. Patterson y sus colaboradores definieron RAID como Arreglo Redundante de
Discos Económicos (Redundant Array of Inexpensive Disks), pero la industria redefinió la I para que
indicara “Independiente” en vez de “económico” (¿tal vez para que pudieran cobrar más?). Como
también se necesitaba un villano (como en RISC contra CISC, también debido a Patterson), el tipo
malo aquí era SLED (Single Large Expensive Disk, Un solo disco grande y costoso).

La idea básica detrás de un RAID es instalar una caja llena de discos a un lado de la computadora
(que por lo general es un servidor grande), reemplazar la tarjeta controladora de discos con
un controlador RAID, copiar los datos al RAID y después continuar la operación normal. En otras
palabras, un RAID se debe ver como un SLED para el sistema operativo, pero con mejor rendimiento
y confiabilidad. Como los discos SCSI tienen un buen rendimiento, bajo costo y la capacidad
de tener hasta siete unidades en un solo controlador (15 para SCSI amplio), es natural que
la mayoría de los RAIDs consistan en un controlador RAID SCSI más una caja de discos SCSI
que el sistema operativo considere como un solo disco grande. De esta forma no se requieren cambios
en el software para utilizar el RAID; un gran punto de venta para muchos administradores de
sistemas.

CD-ROMs

En años recientes se han empezado a utilizar los discos ópticos (en contraste a los magnéticos). Estos
discos tienen densidades de grabación mucho más altas que los discos magnéticos convencionales.
Los discos ópticos se desarrollaron en un principio para grabar programas de televisión, pero
se les puede dar un uso más estético como dispositivos de almacenamiento de computadora. Debido
a su capacidad potencialmente enorme, los discos ópticos han sido tema de una gran cantidad de
investigación y han pasado por una evolución increíblemente rápida.
Los discos ópticos de primera generación fueron inventados por el conglomerado de electrónica
holandés Philips, para contener películas. Tenían 30 centímetros de diámetro y se comercializaron
bajo el nombre LaserVision, pero no tuvieron mucha popularidad, excepto en Japón.
En 1980, Philips y Sony desarrollaron el CD (Disco Compacto), que sustituyó rápidamente al
disco de vinilo de 33 1/3 RPM que se utilizaba para música (excepto entre los conocedores, que
aún preferían el vinilo). Los detalles técnicos precisos para el CD se publicaron en un Estándar Internacional
oficial (IS 10149) conocido popularmente como el Libro rojo debido al color de su
portada (los Estándares Internacionales son emitidos por la Organización Internacional de Estándares,
que es la contraparte internacional de los grupos de estándares nacionales como ANSI, DIN,
etc. Cada uno tiene un número IS). El punto de publicar las especificaciones de los discos y las
unidades como un estándar internacional tiene como fin permitir que los CDs de distintas compañías
disqueras y los reproductores de distintos fabricantes electrónicos puedan funcionar en conjunto.
Todos los CDs tienen 120 mm de diámetro y 1.2 mm de grosor, con un hoyo de 15 mm en
medio. El CD de audio fue el primer medio de almacenamiento digital masivo en el mercado. Se
supone que deben durar 100 años. Por favor consulte de nuevo en el 2080 para saber cómo le fue
al primer lote.


Un CD se prepara en varios pasos. El primero consiste en utilizar un láser infrarrojo de alto poder
para quemar hoyos de 0.8 micrones de diámetro en un disco maestro con cubierta de vidrio. A
partir de este disco maestro se fabrica un molde, con protuberancias en lugar de los hoyos del láser.
En este molde se inyecta resina de policarbonato fundido para formar un CD con el mismo patrón
de hoyos que el disco maestro de vidrio. Después se deposita una capa muy delgada de aluminio
reflectivo en el policarbonato, cubierta por una laca protectora y finalmente una etiqueta. Las depresiones
en el sustrato de policarbonato se llaman hoyos (pits); las áreas no quemadas entre los hoyos
se llaman áreas lisas (lands).
Cuando se reproduce, un diodo láser de baja energía emite luz infrarroja con una longitud de onda
de 0.78 micrones sobre los hoyos y áreas lisas a medida que van pasando. El láser está del lado del
policarbonato, por lo que los hoyos salen hacia el láser como protuberancias en la superficie de área
lisa. Como los hoyos tienen una altura de un cuarto de la longitud de onda de la luz del láser, la luz
que se refleja de un hoyo está desfasada por media longitud de onda con la luz que se refleja de la superficie
circundante. Como resultado, las dos partes interfieren en forma destructiva y devuelven menos
luz al fotodetector del reproductor que la luz que rebota de un área lisa. Así es como el reproductor
puede diferenciar un hoyo de un área lisa. Aunque podría parecer más simple utilizar un hoyo para
grabar un 0 y un área lisa para grabar un 1, es más confiable utilizar una transición de hoyo a área lisa
o de área lisa a un hoyo para un 1 y su ausencia como un 0, por lo que se utiliza este esquema.
Los hoyos y las áreas lisas se escriben en una sola espiral continua, que empieza cerca del hoyo
y recorre una distancia de 32 mm hacia el borde. La espiral realiza 22,188 revoluciones alrededor
del disco (aproximadamente 600 por milímetro). Si se desenredara, tendría 5.6 km de largo. 


Para reproducir la música a una velocidad uniforme, es necesario un flujo continuo de hoyos y
áreas a una velocidad lineal constante. En consecuencia, la velocidad de rotación del CD se debe
reducir en forma continua a medida que la cabeza de lectura se desplaza desde la parte interna del
CD hacia la parte externa. En el interior la velocidad de rotación es de 530 RPM para lograr la velocidad
de flujo continuo deseada de 120 cm/seg; en el exterior tiene que reducirse a 200 RMP para
proporcionar la misma velocidad lineal en la cabeza. Una unidad de velocidad lineal constante
es muy distinta a una unidad de disco magnético, que opera a una velocidad angular constante, sin
importar dónde se encuentre la cabeza en un momento dado. Además, 530 RPM están muy lejos de
las 3600 a 7200 RPM a las que giran la mayoría de los discos magnéticos.

En 1984, Philips y Sony se dieron cuenta del potencial de utilizar CDs para almacenar datos de
computadora, por lo cual publicaron el Libro amarillo que define un estándar preciso para lo que
se conoce ahora como CD-ROMs (Compact disk-read only memory, Disco compacto–memoria
de sólo lectura). Para apoyarse en el mercado de CDs de audio, que para ese entonces ya era considerable,
los CD-ROMs tenían que ser del mismo tamaño físico que los CDs de audio, ser compatibles
en sentido mecánico y óptico con ellos, y se debían producir utilizando las mismas máquinas
de moldeado por inyección de policarbonato. Las consecuencias de esta decisión fueron que no sólo
se requerían motores lentos de velocidad variable, sino también que el costo de fabricación de un
CD-ROM estaría muy por debajo de un dólar en un volumen moderado.


CD-Grabables
En un principio, el equipo necesario para producir un CD-ROM maestro (o CD de audio, para esa
cuestión) era extremadamente costoso. Pero como siempre en la industria de las computadoras, nada
permanece costoso por mucho tiempo. A mediados de la década de 1990, los grabadores de CDs
no más grandes que un reproductor de CD eran un periférico común disponible en la mayoría de las
tiendas de computadoras. Estos dispositivos seguían siendo distintos de los discos magnéticos, porque
una vez que se escribía información en ellos no podía borrarse. Sin embargo, rápidamente encontraron
un nicho como medio de respaldo para discos duros grandes y también permitieron que
individuos o empresas que iniciaban operaciones fabricaran sus propios CD-ROMs de distribución
limitada, o crear CDs maestros para entregarlos a plantas de duplicación de CDs comerciales de alto
volumen. Estas unidades se conocen como CD-Rs (CD-Grabables).


CD-Regrabables
Aunque las personas están acostumbradas a otros medios de escritura de sólo una vez como el papel
y la película fotográfica, hay una demanda por el CD-ROM regrabable. Una tecnología que ahora
está disponible es la del CD-RW (CD-Regrabable), que utiliza medios del mismo tamaño que
el CD-R. Sin embargo, en vez de colorante de cianina o ptalocianina, el CD-RW utiliza una aleación
de plata, indio, antimonio y telurio para la capa de grabación. Esta aleación tiene dos estados
estables: cristalino y amorfo, con distintas reflectividades.
Las unidades de CD-RW utilizan láseres con tres potencias: en la posición de alta energía, el
láser funde la aleación y la convierte del estado cristalino de alta reflectividad al estado amorfo de
baja reflectividad para representar un hoyo; en la posición de energía media, la aleación se funde y
se vuelve a formar en su estado cristalino natural para convertirse en un área lisa nuevamente; en
baja energía se detecta el estado del material (para la lectura), pero no ocurre una transición de
estado.
La razón por la que el CD-RWno ha sustituido al CD-R es que los CD-RWen blanco son más
costosos. Además, para las aplicaciones que consisten en respaldar discos duros, el hecho de que
una vez escrito el CD-R no se pueda borrar accidentalmente es una gran ventaja.


DVD
El formato básico de CD/CD-ROM ha estado en uso desde 1980. La tecnología ha mejorado desde
entonces, por lo que ahora los discos ópticos de mayor capacidad son económicamente viables y
hay una gran demanda por ellos. Hollywood estaría encantado de eliminar las cintas de video análogas
a favor de los discos digitales, ya que los discos tienen una mayor calidad, son más económicos
de fabricar, duran más tiempo, ocupan menos espacio en las repisas de las tiendas de video y
no tienen que rebobinarse. Las empresas de electrónica para el consumidor siempre están buscando
un nuevo producto que tenga un gran éxito, y muchas empresas de computadoras desean agregar
características de multimedia a su software.

El DVD fue ideado por un consorcio de 10 empresas de aparatos electrónicos para el hogar,
siete de ellas japonesas, en estrecha cooperación con los principales estudios de Hollywood (algunos
de los cuales son propiedad de las empresas de electrónica japonesas que están en el consorcio).
Las industrias de las computadoras y las telecomunicaciones no fueron invitadas al picnic, y
el enfoque resultante estuvo en utilizar el DVD para exposiciones de renta y venta de películas. Por
ejemplo, las características estándar incluyen la omisión en tiempo real de escenas sucias (para permitir
que los padres conviertan una película con clasificación NC17 en una segura para los bebés),
sonido de seis canales y soporte para Pan-and-Scan. Esta última característica permite al reproductor
del DVD decidir en forma dinámica cómo cortar los bordes izquierdo y derecho de las película
(cuya proporción de anchura:altura es 3:2) para adaptarlas a los televisores actuales (cuya proporción
de aspecto es 4:3).


jueves, 30 de junio de 2016


Administracion de memoria 

La parte del sistema operativo que administra (parte de) la jerarquía de memoria se conoce como

administrador de memoria. Su trabajo es administrar la memoria con eficiencia: llevar el registro

de cuáles partes de la memoria están en uso, asignar memoria a los procesos cuando la

necesiten y desasignarla cuando terminen.


SIN ABSTRACCIÓN DE MEMORIA
La abstracción más simple de memoria es ninguna abstracción. Las primeras computadoras mainframe

(antes de 1960), las primeras minicomputadoras (antes de 1970) y las primeras computadoras

personales (antes de 1980) no tenían abstracción de memoria. Cada programa veía simplemente

la memoria física. Cuando un programa ejecutaba una instrucción como

MOV REGISTRO1, 1000

la computadora sólo movía el contenido de la ubicación de memoria física 1000 a REGISTRO1. Así,

el modelo de programación que se presentaba al programador era simplemente la memoria física,

un conjunto de direcciones desde 0 hasta cierto valor máximo, en donde cada dirección correspondía

a una celda que contenía cierto número de bits, comúnmente ocho.

Bajo estas condiciones, no era posible tener dos programas ejecutándose en memoria al mismo

tiempo. Si el primer programa escribía un nuevo valor en, por ejemplo, la ubicación 2000, esto borraría

cualquier valor que el segundo programa estuviera almacenando ahí. Ambos programas fallarían

de inmediato.

Incluso cuando el modelo de memoria consiste en sólo la memoria física hay varias opciones

posibles. En la figura 3-1 se muestran tres variaciones. El sistema operativo puede estar en la parte

inferior de la memoria en la RAM (Random Access Memory, Memoria de acceso aleatorio), como

se muestra en la figura 3-1(a), puede estar en la ROM (Read Only Memory, Memoria de sólo lectura)

en la parte superior de la memoria, como se muestra en la figura 3-1(b), o los controladores

de dispositivos pueden estar en la parte superior de la memoria en una ROM y el resto del sistema

en RAM más abajo, como se muestra en la figura 3-1(c). El primer modelo se utilizó antes en las

mainframes y minicomputadoras, pero actualmente casi no se emplea. El segundo modelo se utiliza

en algunas computadoras de bolsillo y sistemas integrados. El tercer modelo fue utilizado por las

primeras computadoras personales (por ejemplo, las que ejecutaban MS-DOS), donde la porción

del sistema en la ROM se conoce como BIOS (Basic Input Output System, Sistema básico de entrada

y salida). Los modelos (a) y (c) tienen la desventaja de que un error en el programa de usuario

puede borrar el sistema operativo, posiblemente con resultados desastrosos (la información del

disco podría quedar ininteligible).


UNA ABSTRACCIÓN DE MEMORIA:
ESPACIOS DE DIRECCIONES
Con todo, exponer la memoria física a los procesos tiene varias desventajas. En primer lugar, si los
programas de usuario pueden direccionar cada byte de memoria, pueden estropear el sistema operativo
con facilidad, ya sea intencional o accidentalmente, con lo cual el sistema se detendría en forma
súbita (a menos que haya hardware especial como el esquema de bloqueo y llaves de la IBM 360).

La noción de un espacio de direcciones
Una mejor solución es inventar una nueva abstracción para la memoria: el espacio de direcciones.
Así como el concepto del proceso crea un tipo de CPU abstracta para ejecutar programas, el
espacio de direcciones crea un tipo de memoria abstracta para que los programas vivan ahí. Un espacio
de direcciones (address space) es el conjunto de direcciones que puede utilizar un proceso
para direccionar la memoria. Cada proceso tiene su propio espacio de direcciones, independiente de
los que pertenecen a otros procesos (excepto en ciertas circunstancias especiales en donde los procesos
desean compartir sus espacios de direcciones).
El concepto de un espacio de direcciones es muy general y ocurre en muchos contextos. Considere
los números telefónicos. En los Estados Unidos y en muchos otros países, un número de teléfono
local es comúnmente un número de 7 dígitos. En consecuencia, el espacio de direcciones
para los números telefónicos varía desde 0,000,000 hasta 9,999,999, aunque algunos números, como
los que empiezan con 000, no se utilizan. Con el crecimiento de los teléfonos celulares, módems
y máquinas de fax, este espacio se está volviendo demasiado pequeño, en cuyo caso habrá qué utilizar
más dígitos. El espacio de direcciones para los puertos de E/S en el Pentium varía desde 0 hasta
16383. Las direcciones IPv4 son números de 32 bits, por lo que su espacio de direcciones varía
desde 0 hasta 232 – 1 (de nuevo, con ciertos números reservados).


MEMORIA VIRTUAL
Como consecuencia de estos desarrollos, existe la necesidad de ejecutar programas que son demasiado
grandes como para caber en la memoria y sin duda existe también la necesidad de tener
sistemas que puedan soportar varios programas ejecutándose al mismo tiempo, cada uno de los cuales
cabe en memoria, pero que en forma colectiva exceden el tamaño de la misma. El intercambio
no es una opción atractiva, ya que un disco SATA ordinario tiene una velocidad de transferencia pico
de 100 MB/segundo a lo más, lo cual significa que requiere por lo menos 10 segundos para intercambiar
un programa de 1 GB de memoria a disco y otros 10 segundos para intercambiar un
programa de 1 GB del disco a memoria.


ALGORITMOS DE REEMPLAZO DE PÁGINAS
Cuando ocurre un fallo de página, el sistema operativo tiene que elegir una página para desalojarla
(eliminarla de memoria) y hacer espacio para la página entrante. Si la página a eliminar se modificó
mientras estaba en memoria, debe volver a escribirse en el disco para actualizar la copia del mismo.
No obstante, si la página no se ha modificado (por ejemplo, si contiene el texto del programa), la
copia ya está actualizada y no se necesita rescribir. La página que se va a leer sólo sobrescribe en
la página que se va a desalojar.
Aunque sería posible elegir una página al azar para desalojarla en cada fallo de página, el rendimiento
del sistema es mucho mayor si se selecciona una página que no sea de uso frecuente. Si
se elimina una página de uso frecuente, tal vez tenga que traerse de vuelta rápidamente, lo cual produce
una sobrecarga adicional. Se ha realizado mucho trabajo, tanto teórico como experimental en
el tema de los algoritmos de reemplazo de páginas.


CUESTIONES DE IMPLEMENTACIÓN
Los implementadores de los sistemas de memoria virtual tienen que elegir entre los principales algoritmos
teóricos: entre el algoritmo de segunda oportunidad y el de envejecimiento, entre la asignación
de páginas local o global, y entre la paginación bajo demanda o la prepaginación. Pero
también tienen que estar al tanto de varias cuestiones prácticas de implementación. En esta sección
daremos un vistazo a unos cuantos de los problemas comunes y ciertas soluciones.


SEGMENTACIÓN
La memoria virtual que hemos analizado hasta ahora es unidimensional, debido a que las direcciones
virtuales van desde 0 hasta cierta dirección máxima, una dirección después de la otra. Para muchos
problemas, tener dos o más espacios de direcciones virtuales separados puede ser mucho mejor
que tener sólo uno. Por ejemplo, un compilador tiene muchas tablas que se generan a medida que
procede la compilación, las cuales posiblemente incluyen:
1. El texto del código fuente que se guarda para el listado impreso (en sistemas de procesamiento
por lotes).
2. La tabla de símbolos, que contiene los nombres y atributos de las variables.
3. La tabla que contiene todas las constantes enteras y de punto flotante utilizadas.
4. El árbol de análisis sintáctico, que contiene el análisis sintáctico del programa.
5. La pila utilizada para las llamadas a procedimientos dentro del compilador.


INVESTIGACIÓN ACERCA DE LA ADMINISTRACIÓN
DE MEMORIA
La administración de memoria, en especial los algoritmos de paginación, fue alguna vez un área
fructífera para la investigación, pero la mayor parte de eso parece haber desaparecido desde hace
mucho tiempo, por lo menos para los sistemas de propósito general. La mayoría de los sistemas reales
tienden a utilizar cierta variación sobre el reloj, debido a que es fácil de implementar y relativamente
efectivo. Sin embargo, una excepción reciente es un rediseño del sistema de memoria virtual
de BSD 4.4 (Cranor y Prulkar, 1999).
Sin embargo, aún se están realizando investigaciones sobre la paginación en los tipos más recientes
de sistemas. Por ejemplo, los teléfonos celulares y los PDAs se han convertido en pequeñas
PCs y muchps de ellas paginan la RAM al “disco”, sólo que el disco en un teléfono celular es la
memoria flash, que tiene propiedades distintas a las de un disco magnético giratorio. Cierto trabajo
reciente se reporta (In y colaboradores, 2007; Joo y colaboradores, 2006; y Park y colaboradores,
2004a). Park y colaboradores (2004b) también han analizado la paginación por demanda
consciente de la energía en los dispositivos móviles.


jueves, 23 de junio de 2016

PROBLEMAS CLÁSICOS DE LA COMUNICACIÓN ENTRE PROCESOS


La literatura de sistemas operativos está repleta de interesantes problemas que se han descrito y analizado ampliamente, mediante el uso de una variedad de métodos de sincronización. En las siguientes secciones examinaremos dos de los problemas más conocidos.


     El problema de los filósofos comelones.

 En 1965, Dijkstra propuso y resolvió un problema de sincronización al que llamó el problema de los filósofos comelones. Desde ese momento, todos los que inventaban otra primitiva de sincronización se sentían obligados a demostrar qué tan maravillosa era esa nueva primitiva, al mostrar con qué elegancia resolvía el problema de los filósofos comelones. Este problema se puede enunciar simplemente de la siguiente manera. Cinco filósofos están sentados alrededor de una mesa circular. Cada filósofo tiene un plato de espagueti. El espagueti es tan resbaloso, que un filósofo necesita dos tenedores para comerlo. Entre cada par de platos hay un tenedor.
La distribución de la mesa se ilustra en la figura


La vida de un filósofo consiste en periodos alternos de comer y pensar (esto es algo así como una abstracción, incluso para los filósofos, pero las otras actividades son irrelevantes aquí). Cuando un filósofo tiene hambre, trata de adquirir sus tenedores izquierdo y derecho, uno a la vez, en cualquier orden. Si tiene éxito al adquirir dos tenedores, come por un momento, después deja los tenedores y continúa pensando. La pregunta clave es: ¿puede usted escribir un programa para cada filósofo, que haga lo que se supone debe hacer y nunca se trabe? (Hemos recalcado que el requerimiento de los dos tenedores es algo artificial; tal vez deberíamos cambiar de comida italiana a comida china y sustituir el espagueti por arroz y los tenedores por palillos chinos).


La solución que se presenta en la figura está libre de interbloqueos y permite el máximo paralelismo para un número arbitrario de filósofos. Utiliza un arreglo llamado estado para llevar el
registro de si un filósofo está comiendo, pensando o hambriento (tratando de adquirir tenedores). Un filósofo sólo se puede mover al estado de comer si ningún vecino está comiendo. Los i vecinos del filósofo se definen mediante las macros IZQUIERDO y DERECHO. En otras palabras, si i es 2, IZQUIERDO es 1 y DERECHO es 3. El programa utiliza un arreglo de semáforos, uno por cada filósofo, de manera que los filó- sofos hambrientos puedan bloquearse si los tenedores que necesitan están ocupados. Observe que cada proceso ejecuta el procedimiento filosofo como su código principal, pero los demás procedimientos (tomar_tenedores, poner_tenedores y probar) son ordinarios y no procesos separados.


 Una solución al problema de los filósofos comelones.


 El problema de los lectores y escritores

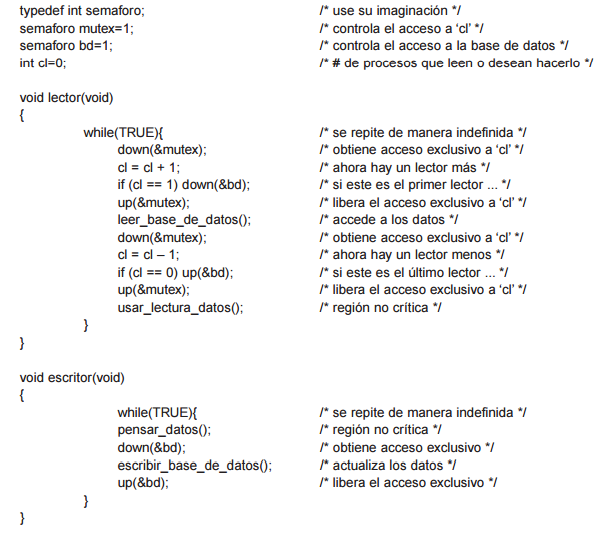
El problema de los filósofos comelones es útil para modelar procesos que compiten por el acceso exclusivo a un número limitado de recursos, como los dispositivos de E/S. Otro problema famoso es el de los lectores y escritores (Courtois y colaboradores, 1971), que modela el acceso a una base de datos. Por ejemplo, imagine un sistema de reservación de aerolíneas, con muchos procesos en competencia que desean leer y escribir en él. Es aceptable tener varios procesos que lean la base de datos al mismo tiempo, pero si un proceso está actualizando (escribiendo) la base de datos, ningún otro proceso puede tener acceso a la base de datos, ni siquiera los lectores. La pregunta es, ¿cómo se programan los lectores y escritores? 


Una solución se muestra en la figura. En esta solución, el primer lector en obtener acceso a la base de datos realiza una operación down en el semáforo bd. Los siguientes lectores simplemente incrementan un contador llamado cl. A medida que los lectores van saliendo, decrementan el contador y el último realiza una operación up en el semáforo, para permitir que un escritor bloqueado (si lo hay) entre. La solución que se presenta aquí contiene en forma implícita una decisión sutil que vale la pena observar. Suponga que mientras un lector utiliza la base de datos, llega otro lector. Como no es un problema tener dos lectores al mismo tiempo, el segundo lector es admitido. También se pueden admitir más lectores, si es que llegan. Ahora suponga que aparece un escritor. Tal vez éste no sea admitido a la base de datos, ya que los escritores deben tener acceso exclusivo y por ende, el escritor se suspende. Más adelante aparecen lectores adicionales.


 Mientras que haya un lector activo, se admitirán los siguientes lectores. Como consecuencia de esta estrategia, mientras que haya un suministro continuo de lectores, todos entrarán tan pronto lleguen. El escritor estará suspendido hasta que no haya un lector presente. Si llega un nuevo lector, por decir cada 2 segundos y cada lector requiere 5 segundos para hacer su trabajo, el escritor nunca entrará. Para evitar esta situación, el programa se podría escribir de una manera ligeramente distinta: cuando llega un lector y hay un escritor en espera, el lector se suspende detrás del escritor, en vez de ser admitido de inmediato. De esta forma, un escritor tiene que esperar a que terminen los lectores que estaban activos cuando llegó, pero no tiene que esperar a los lectores que llegaron después de él. La desventaja de esta solución es que logra una menor concurrencia y por ende, un menor rendimiento. Courtois y sus colaboradores presentan una solución que da prioridad a los escritores


. Una solución al problema de los lectores y escritores.